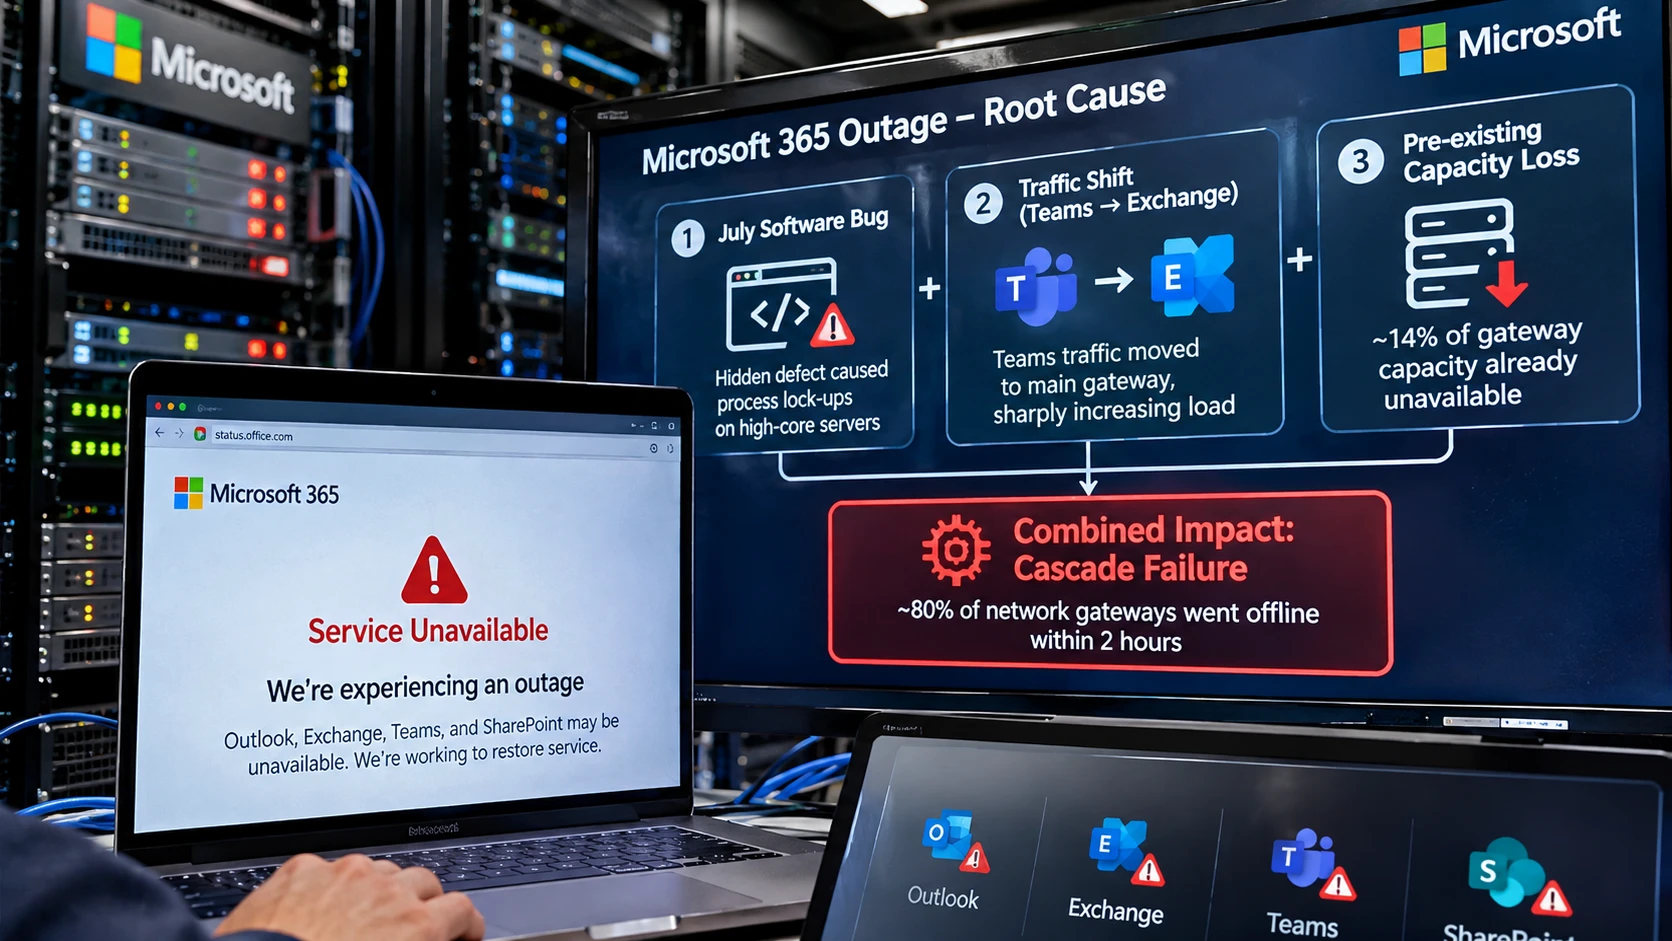
마이크로소프트가 지난 12일(목) 발생한 마이크로소프트 365 대규모 서비스 장애의 원인을 공식적으로 설명했다. 올 7월에 도입한 소프트웨어 버그가 두 가지 인프라 문제와 맞물려 연쇄 장애를 일으켰으며, 최악의 순간에는 네트워크 게이트웨이 서버의 80%가 먹통이 됐던 것으로 드러났다.
지난 11일(수) 마이크로소프트 팀즈의 단기 장애에 이어, 12일부터 아웃룩, 익스체인지 온라인, 팀즈, 셰어포인트 등 마이크로소프트 365 전반에 걸쳐 대규모 서비스 장애가 발생했다. 마이크로소프트의 초기 복구 시도가 연이어 실패하면서 수백만 명의 사용자들이 12시간 넘게 이메일과 각종 서비스를 이용하지 못했다.
세 가지 문제의 치명적 결합
마이크로소프트 임원 찰스 라만나가 X(구 트위터)에 공개한 사고 경위는 다음과 같다.
① 7월의 숨겨진 버그 2026년 7월, 마이크로소프트 365 네트워크 게이트웨이 서버의 수정 패치에 소프트웨어 결함이 함께 유입됐다. 이 버그는 특정 작업 환경에서 내부 프로세스에 잠금 경합(lock contention)을 일으켜 서버를 응답 불능 상태로 만들었다. 문제는 이 패치가 정식 테스트를 통과한 뒤 수 주에 걸쳐 전 세계에 배포됐음에도 아무런 이상이 발견되지 않았다는 점이다.
나중에 밝혀진 사실이지만, 테스트 환경이 주로 CPU 코어 수가 적은 구형 하드웨어로 구성돼 있었던 것이 문제였다. 이 버그는 코어 수가 많은 최신 서버에서 훨씬 더 쉽게 발현되는 특성을 갖고 있었기 때문이다.
② 트래픽 패턴의 변화 장애 발생 수 시간 전, 팀즈 트래픽이 보조 게이트웨이에서 익스체인지 온라인도 함께 처리하는 주 게이트웨이로 이전됐다. 이는 팀즈의 정상 작동을 위한 통상적인 페일오버(failover) 조치였으나, 주 게이트웨이의 부하가 급증하고 트래픽 패턴이 변화하는 결과를 낳았다.
③ 전날부터 발생한 용량 부족 장애 전날부터 무관한 별도 문제로 인해 게이트웨이 서버 용량의 약 14%가 이미 사용 불가 상태였다. 남은 86%의 용량은 평소 수준의 트래픽을 처리하기에 충분했으나, 위의 두 조건과 맞물리면서 임계점을 넘어버렸다.
연쇄 붕괴, 2시간 만에 80% 마비
세 가지 문제가 동시에 겹치자 숨겨져 있던 버그가 발동했다. 늘어난 팀즈 트래픽과 줄어든 서버 용량이 맞물려 버그를 촉발한 것이다.
서버가 응답 불능 상태에 빠지면 마이크로소프트 인프라는 자동으로 트래픽을 정상 서버로 우회시키도록 설계돼 있다. 하지만 이 복구 메커니즘이 오히려 상황을 악화시켰다. 대규모 우회 트래픽을 받은 정상 서버들도 순차적으로 같은 버그를 일으키며 쓰러지기 시작한 것이다. 불과 2시간도 안 되는 시간 안에 장애는 전체 네트워크 게이트웨이의 80%로 확산됐다.
통상적으로 이런 연쇄 장애는 별도의 용량 파티션과 지역 분리 구조로 차단되지만, 이번에는 또 다른 문제로 인해 이 안전망마저 작동하지 않아 장애가 전 세계로 번졌다.
팀즈, 원드라이브, 셰어포인트, 오피스 앱 등 일부 서비스는 영향을 받은 게이트웨이 인프라에서 벗어날 수 있었지만, 익스체인지 온라인은 같은 방식의 페일오버가 불가능해 가장 오랫동안 피해를 입었다.
복구 과정도 순탄치 않아
마이크로소프트는 이번 규모의 장애를 처리하도록 설계된 복구 메커니즘이 없었다는 점을 인정했다. 엔지니어들이 장애 서버를 재가동할 때마다 밀려 있던 트래픽이 한꺼번에 몰려 같은 버그를 다시 일으키는 악순환이 반복됐다.
버그가 7월부터 존재해왔기 때문에 단순 롤백도 어려웠다. 결국 마이크로소프트는 문제가 된 코드 경로를 이전의 정상 상태로 되돌리는 별도 업데이트를 개발했다. 이후 대규모 서버 그룹을 순차적으로 오프라인 상태로 전환해 패치를 적용하고 재가동하는 방식으로 서비스를 단계적으로 복구했다.
마이크로소프트는 이번 주 중으로 추가 기술 세부 사항과 재발 방지 대책을 담은 최종 사고 보고서를 발표할 예정이다.